Für Podcaster

Audio rein. Videopodcast raus.

Mach aus der bereits aufgenommenen Episode mit KI einen Videopodcast: ein sprechender Host, aus einem Porträt animiert, Bilder, die dem Audio folgen, eingebrannte Untertitel und Hochformat-Clips. Dazu Transkription mit Sprecherlabels, Voice Cloning und lizenzfreie Musik.

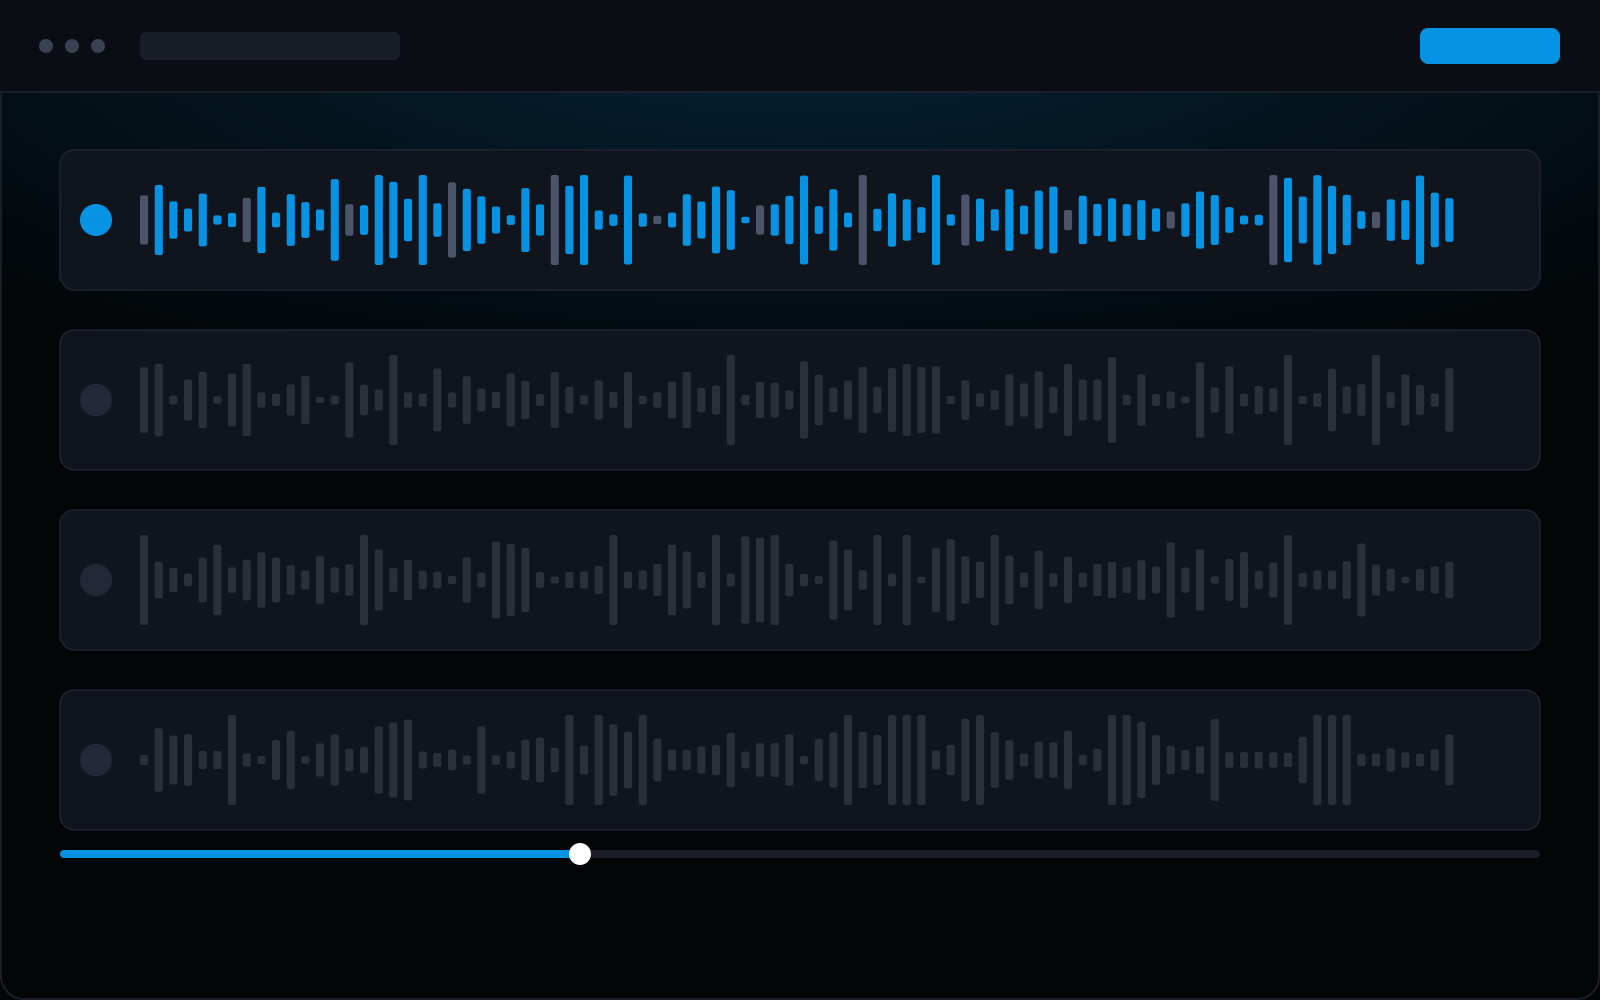
faktry audio suite with tracks, waveform and mixing controls

Die Episode ist fertig. Die Videoversion nicht

Ein Audio-Podcast landet in einem Feed und sonst nirgends, während Videoplattformen ein Gesicht, Bewegung oder wenigstens einen Clip mit Untertiteln wollen. Diese Version zu bauen bedeutet meist Videoeditor, Animation und Untertiteldienst zusätzlich zu den Audio-Tools, die du ohnehin bezahlst. In faktry ist die Aufnahme der Ausgangspunkt für alles: transkribieren, die gewünschten Segmente schneiden, ein Host-Porträt erzeugen, es aus dem Episoden-Audio animieren oder das Audio generierte Bilder steuern lassen, Untertitel einbrennen und Hochformat-Clips exportieren. Jedes Ergebnis landet in einer Bibliothek. 

Das Podcaster-Toolkit

Die Videoversion deiner Episode und die Audio-Tools dahinter.

Den Videopodcast erstellen

Ein sprechender Host aus einem Porträt
Ein Porträt hochladen oder mit einem Bildmodell erzeugen, ein Segment des Episoden-Audios hinzufügen, und Video Avatar animiert das Gesicht so, dass es den Ton spricht. Kling AI Avatar V2 und OmniHuman 1.5 stehen zur Auswahl. Die Episode Segment für Segment abarbeiten.
Bilder, die dem Audio folgen
Audio to Video erzeugt einen Clip, der von 2 bis 20 Sekunden Audio gesteuert wird, und kann ein Startbild wie dein Cover animieren. Praktisch für Teaser, Trailer und die Momente, in denen sonst minutenlang eine Standbildkarte stünde.
Untertitel und Hochformat-Clips
Die SRT aus dem Transkript ins Video einbrennen und dann für Shorts, Reels und TikTok ins Hochformat umformatieren. Clips schneiden und zusammenfügen geht in derselben Video-Suite.

Das Audio produzieren

Transkription mit Sprecherlabels
Transkribieren mit Whisper-1 oder ElevenLabs Scribe v2, das jeden Sprecher automatisch erkennt und benennt. Export als Text, SRT, VTT oder JSON mit Zeitstempeln. Ein 60-Minuten-Interview ist in wenigen Minuten fertig.
Voice Cloning und Sprache
Die eigene Stimme aus einer kurzen Probe klonen und damit Sponsorenblöcke, Teaser und Narration erzeugen. Oder aus ElevenLabs v3, Gemini TTS und OpenAI-Stimmen wählen, wenn du einen anderen Sprecher willst.
Musik, Mix und Aufräumen
Lizenzfreie Intro- und Outromusik mit oder ohne Gesang erzeugen, dann Spuren mischen, Stille trimmen, Segmente zusammenfügen und zwischen MP3, WAV, OGG, AAC und M4A konvertieren. Keine Lizenzgebühren bei kommerzieller Nutzung.

Die Modelle hinter dem Workflow

Modelle per Auswahlfeld wechseln. Gleiches Guthaben, keine separaten Anbieterkonten.

Transkription, Text-to-Speech, Voice Cloning und Musikerzeugung

  • ElevenLabs
  • OpenAI TTS
  • Gemini TTS
  • MiniMax Music

Von der Audio-Episode zum Videopodcast

Was faktry übernimmt, nachdem du die Aufnahme beendest.

Die Aufnahme aufräumen

Stille trimmen, Segmente zusammenfügen, ein Intro aus dem Musikgenerator einmischen und in das gewünschte Format konvertieren. Gästeclips oder Referenzaudio von YouTube, SoundCloud, Vimeo oder Bandcamp mit dem Audio-Download holen.

  • Trimmen und Zusammenfügen
  • Intromusik
  • Audio-Download

Episode transkribieren

Das fertige Audio hochladen und mit Scribe v2 transkribieren. Sprecherlabels erkennen jeden Gast automatisch. SRT für die Videoversion exportieren oder Text für alles Weitere.

  • Sprecherlabels
  • 50+ Sprachen
  • SRT und VTT

Der Episode ein Gesicht geben

Ein Host-Porträt erzeugen, ein Segment des Episoden-Audios hineingeben und zu einem Clip mit sprechendem Host animieren. Für Teaser und Trailer lässt Audio to Video stattdessen Bilder entstehen, die dem Ton folgen.

  • Host-Porträt
  • Sprechender Avatar
  • Audiogesteuerte Clips

Die Clips schneiden

Untertitel aus der bereits vorhandenen SRT einbrennen, ins Hochformat umformatieren und die stärksten Momente zu Clips für Shorts, Reels und TikTok trimmen.

  • Eingebrannte Untertitel
  • Hochformat-Reframe
  • Clips trimmen

Funktionen im Überblick

Was ein Podcast-Konto plattformweit tatsächlich nutzt.

  • 01Video mit sprechendem Host aus Porträt und Episoden-Audio
  • 02Audiogesteuerte Videoclips aus 2 bis 20 Sekunden Ton
  • 03Sprechererkennung bei Interviews mit mehreren Gästen
  • 04Transkription in 50+ Sprachen mit SRT- und VTT-Export
  • 05Voice Cloning aus einer kurzen Referenzprobe
  • 06Lizenzfreie Musik mit vollen kommerziellen Rechten

Transkription

  • Whisper-1
  • ElevenLabs Scribe v2
  • Sprecherlabels
  • Export mit Zeitstempeln

Stimme

  • Voice Cloning
  • ElevenLabs v3
  • Gemini TTS
  • OpenAI TTS

Musik

  • Instrumentals
  • Komplette Tracks
  • Soundeffekte
  • Lizenzfrei

Video

  • Sprechender Avatar
  • Audio to Video
  • Untertitel einbrennen
  • Hochformat-Reframe

Fragen von Podcastern

Noch Fragen? Kontakt aufnehmen
  • Ja. Ein Host-Porträt erzeugen oder hochladen, ein Segment des Episoden-Audios hinzufügen, und Video Avatar animiert es zu einem Clip mit sprechendem Host. Audio to Video erzeugt Bilder, die einem kurzen Audioabschnitt folgen, Untertitel werden aus dem Transkript eingebrannt, und die Video-Suite rahmt alles ins Hochformat um. Du arbeitest Segment für Segment, nicht mit einem Knopfdruck für die ganze Episode.

Nur für die Episoden zahlen, die entstehen

Credits statt vier Monatsabos. Ein ruhiger Monat kostet nichts.